PDF RAG:表格一压平就输了一半
PDF RAG 不只是抽出文字。本文用可重放对照实验,讲清表格结构保留、解析路由与三层验收。
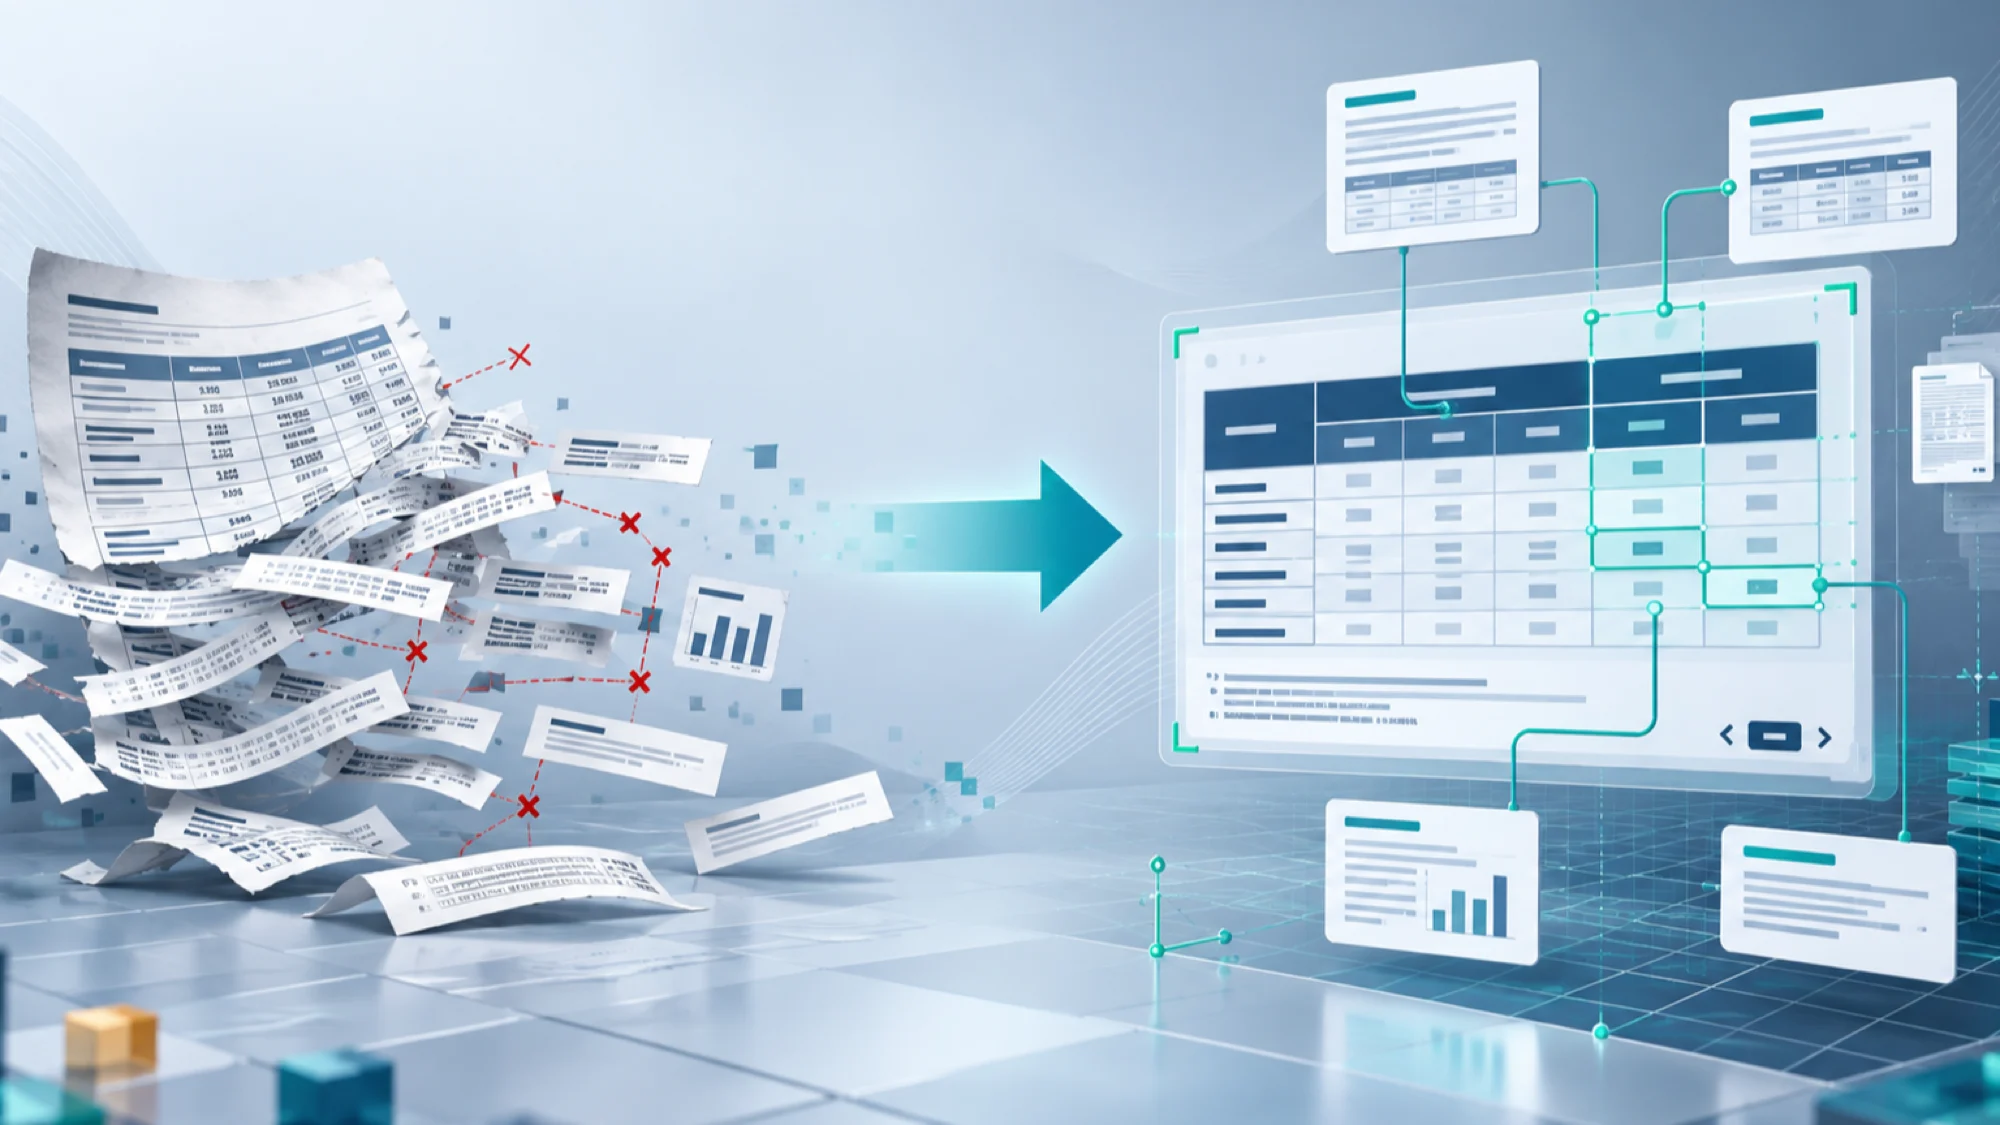
PDF RAG 是先从 PDF 找到外部证据,再让模型据此回答的检索增强生成方法。先给结论:纯段落可以直接抽字切块;表格只要依赖表头、行列、单位或脚注,就应先保留结构真值,再生成检索文本。
标题里的「输了一半」不是 50% 准确率声明,而是提醒:表格的文字和关系各承担一部分意义,压平通常只留下前者。 本文会用一份可下载、可重放的合成 PDF 对照两条入库路径,再给出复杂 PDF 路由、最小数据契约和三层验收方法。
要点速览
- 光学字符识别(OCR,把扫描图像中的字识别成机器文本)能回答「页上有什么字」,不自动回答「这个数属于哪一行哪一列」。
- 表格 RAG 至少要保留表名、完整表头路径、行键、单位、脚注、页码/坐标和源文件指纹。
- 本次 12 问结构保留测试使用黄金字段辅助候选排序:普通压平切块保住 10 组完整证据,结构化行块保住 12 组;它不是现实检索评测,也不是通用模型准确率。
- 普通文本、扫描件、规则表格、复杂表格与视觉密集页面应该走不同解析路径。
- 验收必须拆成解析、检索、回答三层,否则只知道结果错了,不知道错在哪。
先判断这篇是不是你要找的:如果你只想快速做出「上传 PDF 后聊天」的演示,基础 PDF RAG 教程会更直接;这篇默认你已经有一条基本入库链路,正在解决表格证据不完整、错误难定位和解析升级无法回归的问题。
先按你的任务选择阅读路径
| 你是谁 | 优先读哪几节 | 读完应拿到什么 |
|---|---|---|
| 进阶实战学员 | 对照实验 → 解析路由 → 数据契约 | 能用同一份 PDF 比较压平与结构化两条路径,并解释失败发生在哪一层 |
| 企业知识库建设者 | 解析路由 → 三层验收 → 生产上线 | 能产出文档分类规则、黄金问题集、可回滚索引和上线清单 |
| AI 应用工程师 | 数据契约 → 三层验收 → 视觉检索 | 能实现稳定标识、结构化中间层、查询路由和逐层诊断 |
| 技术决策者 | 解析路由 → 生产上线 → 上线前自检 | 能判断哪些文档值得升级重解析,以及何时应阻断、灰度或回滚 |
为什么 PDF RAG 要先分开「文字」和「证据」?
文字完整只说明字符被识别出来;证据完整还要求字符之间的关系能被机器稳定重建。Google Document AI 的布局解析说明直接指出,标准 OCR 会把文档压平,破坏标题、表格、列表和上下文;这也是为什么布局解析器需要额外识别标题、段落、表格与图形。
| 你检查的对象 | 看起来成功 | 真正的完成标志 |
|---|---|---|
| 文字抽取 | 数字、名称都在文本里 | 字符与原页一致,乱码和漏字可定位 |
| 表格理解 | 能看到一串数字 | 每个值能回到行键、完整表头、单位和脚注 |
| 检索 | 找到「相关片段」 | 候选里含齐回答问题所需的全部证据 |
| 回答 | 语言通顺 | 数值、口径和引用都能回到原页 |
💡 通俗讲:把表格想成地图。OCR 抄下了所有地名,结构解析保存了道路和坐标。只剩地名时,你知道地点存在,却不一定知道它们之间怎么走。
Amazon Textract 的表格模型会单独表示单元格、合并单元格、列标题、表题、章节标题、页脚和汇总单元格。Azure Document Intelligence 的复杂表格输出则用 HTML 表达跨行、跨列、标题与脚注。两种输出都把这些关系当作数据保存,而不是当作可以丢掉的排版。
表格压平时,到底丢了什么?
压平容易丢失的是「谁修饰谁」。下面七项里,只要有一项会改变答案,就不能把普通文本切块当作完成态。
- 表名:同一页可能有预算表和实际表,数字相同,口径不同。
- 表头路径:Q2 上方可能还有「H1 实际」,Q4 上方是「H2 预测」。
- 行键:146 是华东还是华南,取决于它和哪一行绑定。
- 跨行跨列关系:合并单元格决定某个标题覆盖哪些列。
- 单位与币种:146 元、146 万元和 146 万美元不是同一个事实。
- 脚注与限定条件:是否含税、是否扣退款、预测截止日期都可能只写在表下。
- 来源位置:没有页码和坐标,系统难以展示证据,也难以人工复核。
可以用一个简单问题做入库前检查:「如果把这一行单独拿出来,陌生人能否知道每个数字的完整含义?」如果答案是否定的,就要把表名、祖先标题、表头路径、单位与脚注重复到这一行的检索投影中。
💡 通俗讲:「检索投影」不是另一份真数据,而是把完整表格改写成更容易被搜索命中的句子;原来的表格结构仍是核对答案的底稿。
⚠️ 常见踩坑:把视觉上很整齐的 Markdown 表格当作无损中间层。普通 Markdown 不能完整表达跨行跨列;复杂表格应保留 HTML 或结构化 JSON,再派生适合嵌入的文字,而不是反过来从文字猜结构。
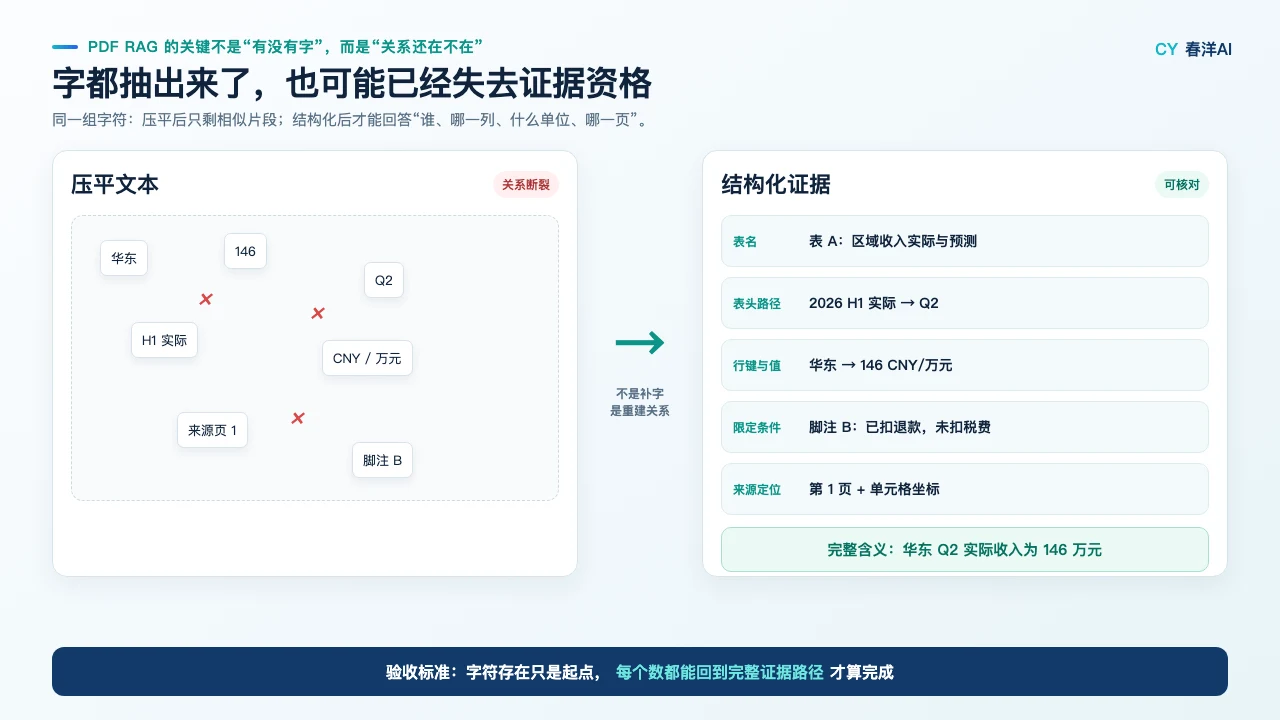
压平并不一定丢字符,却会让表名、表头路径、行键、脚注和来源定位互相断开。
黄金字段辅助对照:压平保住 10/12,结构化保住 12/12
本文配套一份两页合成财务 PDF:第一页包含 7 个区域、两级表头、合并单元格、全年预算、单位和两条脚注,第二页记录实验方法与边界。你可以下载
对照检查。
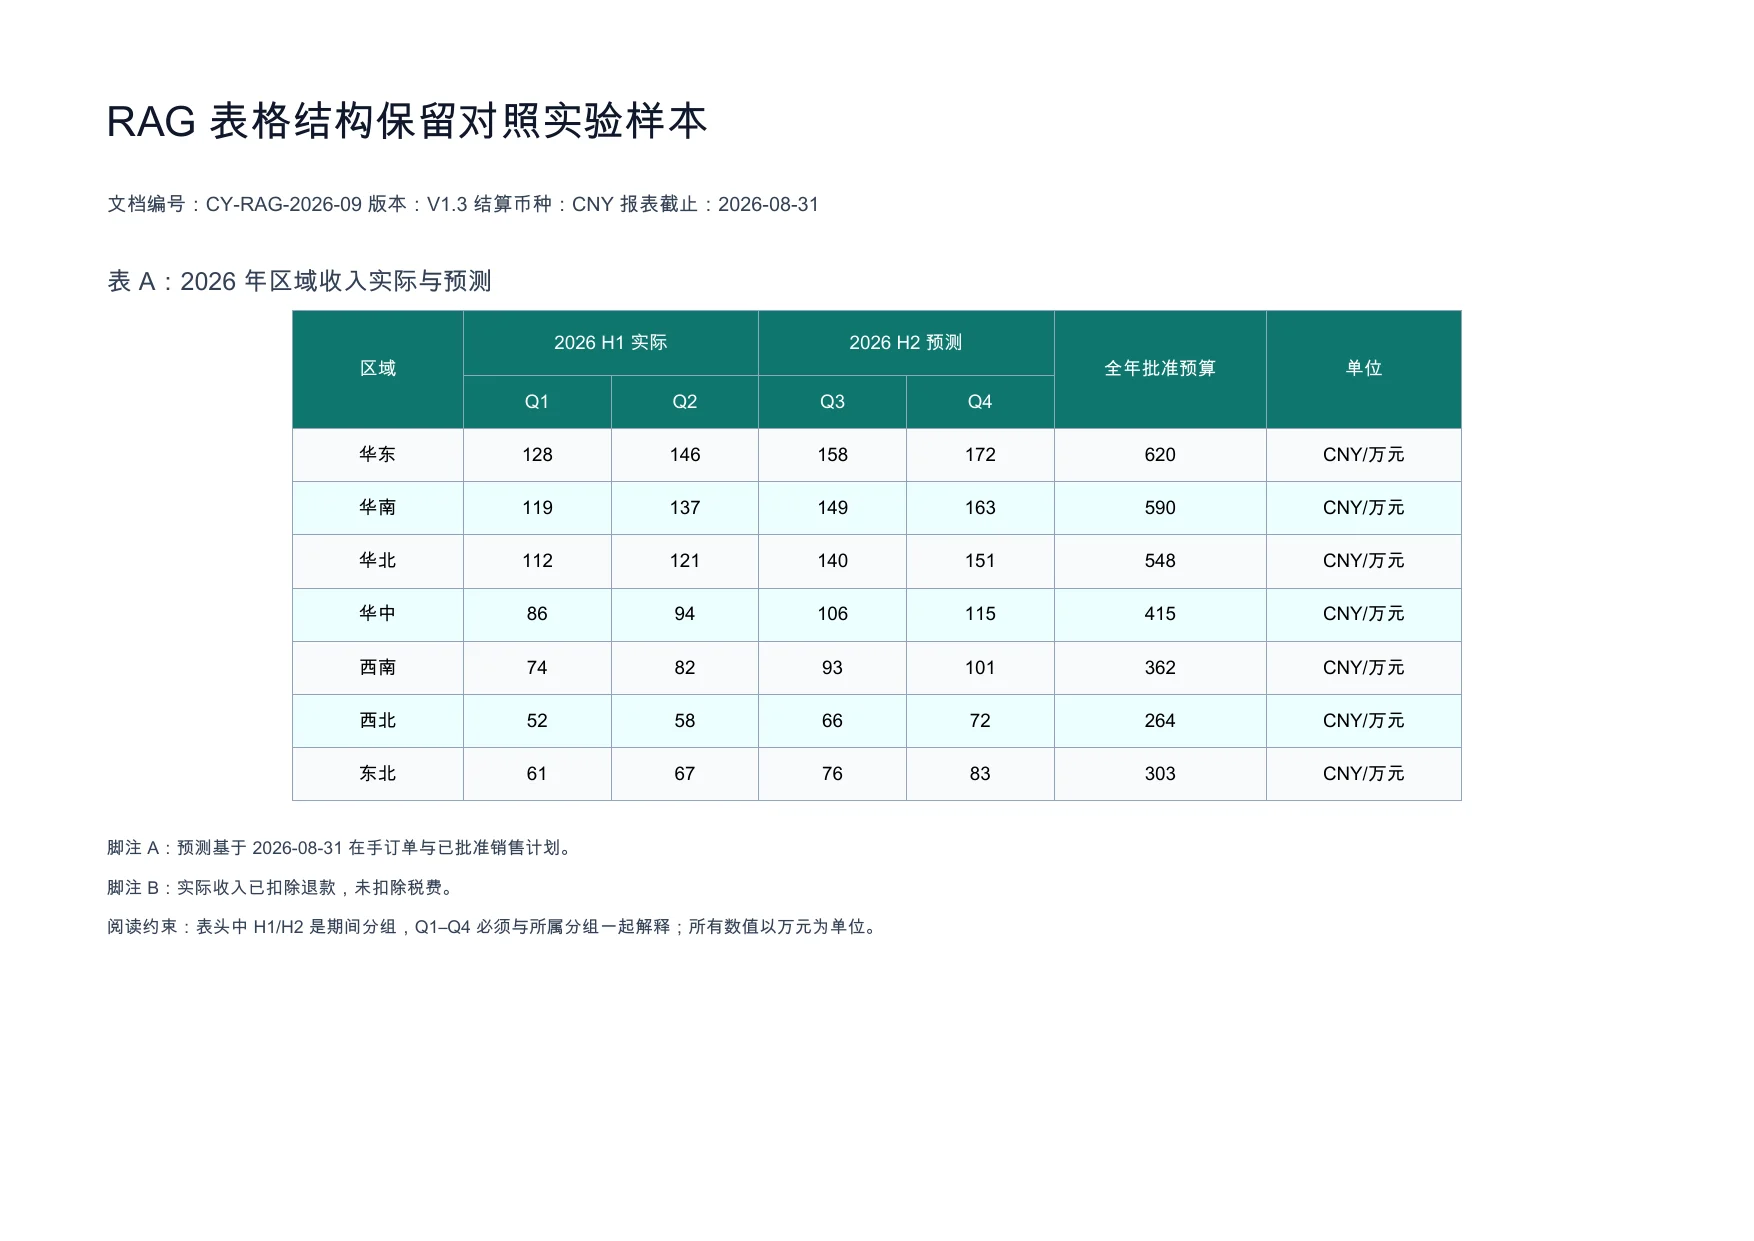
实验原页不是装饰图:后文的 12 个问题、压平失败与结构化通过结果,都以这张表及第 2 页说明为固定输入。
你也可以直接下载完整实验包。其中同时提供源 PDF、run_experiment.py、pdftotext-raw.txt、evaluation.json、evaluation.md 和 README.md。README.md 列出 Python/ReportLab 与 pdftotext 依赖、运行命令和预期输出 flat=10/12、structured=12/12;源 PDF 的 SHA-256 为 548b0b438a55b4d63a657c248e010fa089c71438a205eaee193851ed8441bcb2。下载后,先核对文件清单和指纹,再按 README.md 重跑;结果不一致时,不应用这组数字支持后续决策。
实验固定源文件,但比较的是两套完整入库表示:一边是阅读顺序文本 + 定长切块,另一边是结构化行块 + 上下文重复。这里同时改变了切块边界、上下文重复方式和块数量,因此结果只能证明「这套结构化表示在当前测试中保住了更多必需证据」,不能单独归因于某一个字段或某一种切块算法:
本次实测覆盖 12 个确定性问题。
- 压平路径:使用
pdftotext -raw抽取阅读顺序文本,压缩空白,再按 120 个字符切块,相邻块重叠 12 个字符。 - 结构路径:每个区域生成一个行块,重复表名、完整表头路径、单位、脚注、来源页与源文件 SHA-256 指纹。
- 相同问题:用 12 个确定性问题检查候选块是否含齐必需证据,包括单值、跨行比较、H2 合计、脚注口径、来源页和表名。
- 相同口径:验收器读取每题预先标注的
required字段,按这些字段的命中数给块排序,取前 2 个块,再检查必需字段是否同时出现;不调用嵌入、重排或语言模型。
⚠️ 实验边界:这一步使用了黄金答案字段参与候选排序,所以它是结构保留测试,不是现实检索评测。它能说明「候选块是否有能力装下完整证据」,不能证明只凭用户问题就能召回该块。进入生产前,应改用只从问题生成的关键词、向量或混合检索,再用独立答案标签计算前 k 个候选的必需证据召回率(Evidence Recall@k)。
| 路径 | 候选块总数 | 黄金字段辅助排序后的完整证据通过 | 这组结果说明什么 |
|---|---|---|---|
| 阅读顺序文本 + 定长切块 | 6 | 10/12 | 多数直接数值仍可找回,但来源页、表名等关系可能与目标行分离 |
| 结构化行块 + 上下文重复 | 8 | 12/12 | 当前样本的 12 组必需证据都能在候选中同时出现 |
下面把两个真正拉开差距的问题展开;其余 10 问由发布后的 evaluation.json 给出完整明细。
| QID | 问题 | 必需证据 | 压平 Top-2 缺失 | 结构化 Top-2 |
|---|---|---|---|---|
| Q09 | 华中 Q1 实际值来自哪一页? | 华中、H1 实际、Q1、86、来源页 1 | 来源页 1(失败) | 五项同时命中(通过) |
| Q10 | 西北 Q4 预测与全年批准预算分别是多少? | 西北、H2 预测、Q4、72、全年批准预算、264、CNY/万元 | H2 预测、全年批准预算(失败) | 七项同时命中(通过) |
压平路径通过了 10 问,所以它并非完全不能用。需要拦截的是另外 2 问:Q09 缺少来源页,Q10 缺少「H2 预测」与「全年批准预算」这两个关系标签。候选块仍然很像答案,却不足以核对金额口径或定位原页。
下一轮实验应做一个最小消融:保持相同候选块数和排序器,每次只加回一类关系——表名、表头路径、单位、脚注或页码。它不是为了把文章扩成全栈搭建教程,而是用一次只变一个因素,回答「12/12 究竟由哪些结构字段贡献」。
🔍 深入一步:10/12 与 12/12 只对这份合成 PDF、当前切块参数、问题集和确定性检查器有效。它不代表某个解析器、向量模型或语言模型的普遍准确率,也不能证明企业上线收益。可重放实验的意义,是把「关系不能丢」变成一条持续回归的不变量。
复杂 PDF 应按文档特征分流,不该只走一条解析路径
成本合理的方案不是让所有 PDF 都跑最重的模型,而是先给文档画像,再按失败风险升级。
这里的「文档画像」不是给文件贴抽象标签,而是先检查它有没有文字层、扫描页、规则表格、跨页表格和大量图表,再据此选择解析方法。Unstructured 的 PDF 策略区分了快速、高分辨率、仅 OCR 和自动路由;这说明单一路径不是必然默认。
| 文档特征 | 起步路径 | 何时升级 | 完成标志 |
|---|---|---|---|
| 可搜索、以段落为主 | 直接提取文本 + 标题感知切块 | 阅读顺序或标题层级异常 | 段落、标题、页码可回溯 |
| 规则单表、无合并表头 | 表格解析 + 行/整表双表示 | 行列错位或单位分离 | 单元格坐标和表头路径完整 |
| 扫描件 | OCR + 版面分析 | 字符置信不足或旋转严重 | 关键字段经黄金样本验证 |
| 多级/跨页/嵌套表 | 高精度布局解析 + 应用层拼表 | 拼接规则不稳定 | 跨页连续性和重复表头通过 |
| 图表、流程图、空间关系 | 页面图像检索 + 文本索引 | 仅在视觉问题集上有收益 | 页面证据可展示、成本延迟达标 |
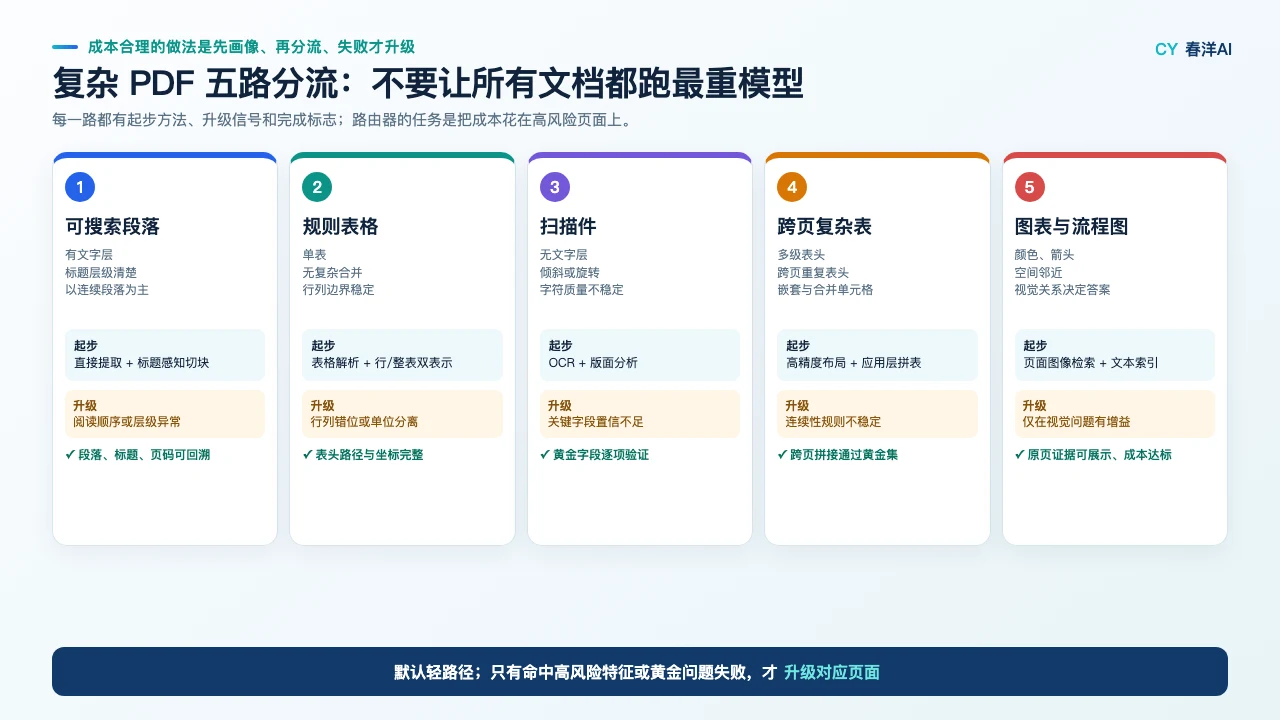
默认走能满足质量要求的轻路径;只有高风险特征或黄金问题失败,才升级对应页面。
第一次实践,按这个最小闭环动手
- 从真实业务里挑一份有金额、单位、脚注或跨页关系的 PDF,保存源文件指纹。
- 人工标出正确页码、表名、表头路径、行键、单位和脚注,写成黄金证据。
- 先跑成本最低的可行路径,把解析结果、检索候选和最终回答分别留档。
- 用同一批黄金问题逐层比对;哪一层失败,就只修那一层,不先换语言模型。
- 只有规则表格或视觉问题仍失败时,才把对应文档升级到布局解析或视觉路径。
- 固定解析器版本与索引版本,重复回归;通过后再扩大文档范围。
这样做的产物不是一段演示对话,而是一份可复用的路由规则、黄金问题集和失败记录。
最小启动卡:
- 选 1 份真实 PDF,写 3 个问题:查数、查单位、查脚注或来源页各一个。
- 每题记录
question | expected_answer | required_evidence | page | pass/fail | failure_layer,再用当前入库路径跑一遍。 - 三题都能回到正确页码、表头路径、单位和脚注,才扩到更多文档;任一题失败,先标记解析层、检索层或回答层,不先更换语言模型。
完成这张卡只代表建立了可验证起点,不代表通过生产验收。
路由器先做低成本检测:有没有可搜索文字、表格数量、跨页候选、合并表头、页面旋转、图片占比和解析置信度。只有黄金问题(人工确认了正确答案和证据位置的固定测试题)失败,或文档特征命中高风险,才升级到更重路径。
⚠️ 常见踩坑:把「结构化解析」当作自动正确。Google 的布局解析文档明确列出跨页 PDF 表格可能被拆成两张表。结构被输出,只表示你有机会验证它,不表示跨页拼接已经完成。
结构化检索块至少要保留哪些字段?
可以把中间层理解为「原 PDF 与搜索系统之间的标准转接层」。稳妥做法是双存一份:结构化真值保存表格原有关系;自然语言投影把同一事实改写成便于搜索的句子。两份数据用同一个编号连接,因此即使更换向量库(保存检索表示的搜索数据库),也能从结构化真值重建。
| 字段 | 回答的问题 | 缺失风险 |
|---|---|---|
| document_id / source_hash | 来自哪个不可变文件版本 | 旧版与新版证据混用 |
| table_id / caption | 属于哪张表 | 同页多表串台 |
| header_path | 这个值的完整列含义是什么 | 实际与预测、季度与年度混淆 |
| row_key | 这个值属于哪个对象 | 地区、产品或科目错位 |
| structure_ref / cell_map | 原表的单元格坐标、合并关系和跨行跨列范围存在哪里 | 只有行块时无法重建复杂表格的结构真值 |
| value / normalized_value | 原值与规范化值是什么 | 百分号、千分位、括号负数误判 |
| unit / currency | 用什么尺度和币种解释 | 金额量级错误 |
| footnotes | 口径、例外和截止条件是什么 | 含税、退款、预测口径丢失 |
| page / bbox | 原页哪里能复核 | 无法展示证据或人工校验 |
| parser / version / config_hash | 谁用什么版本和配置解析 | 同版本参数变化后,错误仍无法定位或重现 |
| confidence / warnings | 哪些结构需要升级或人工看 | 低质量结果悄悄入库 |
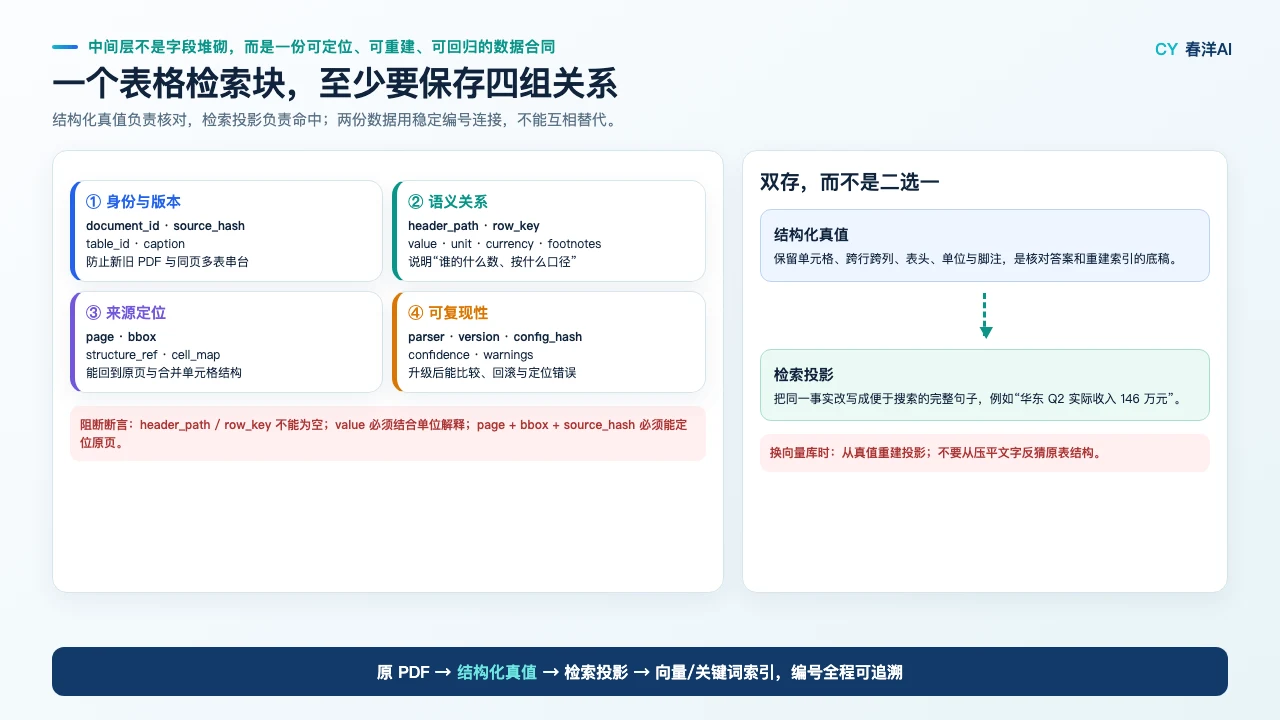
结构化真值负责核对与重建;检索投影负责搜索命中,两者必须用稳定编号连接。
AI 应用工程师可以先用下面这条示意记录验证字段是否真正连在一起;数值只用于演示字段关系:
{
  "document_id": "annual-report-2026",
  "source_hash": "sha256:...",
  "table_id": "revenue-by-region",
  "caption": "2026 年区域收入表",
  "header_path": ["H1 实际", "Q2"],
  "row_key": "华东",
  "structure_ref": "tables/revenue-by-region.json#row=华东",
  "value": "146",
  "normalized_value": 1460000,
  "unit": "万元",
  "currency": "CNY",
  "footnote_refs": ["fn-b"],
  "footnote_map": {"fn-b": {"scope": "actual-values", "text": "实际收入已扣除退款,未扣除税费"}},
  "page": 1,
  "bbox": [72, 188, 228, 214],
  "parser": {"name": "your-parser", "version": "x.y.z", "config_hash": "sha256:..."},
  "confidence": 0.98,
  "warnings": []
}
入库前先做三个断言:
header_path与row_key非空。value保留原始表示;normalized_value能结合unit和currency解释量纲与换算规则。page + bbox + source_hash能定位到不可变原页。
规范化数值不一定能无损还原千分位、括号负数、舍入或原始措辞。断言失败时,只阻断依赖该字段的答案,并转人工或重解析;来源版本、租户权限等全局证据失效时,再阻断整份文档。
表格既要有整表对象,也要有行级或单元格组的检索块。整表承接「哪个地区增长最高」等全局问题;行块承接「华东 Q2 实际是多少」等精确问题。查询涉及求和、比较和分组时,先检索到表,再在结构化值上执行 SQL 或代码,模型负责拆解问题与解释结果。
🎯 实战提示词:请审查这份 PDF 表格的入库数据结构(Schema)。逐项检查
table_id、caption、header_path、row_key、value、unit、footnotes、page、bbox、source_hash、parser_version是否存在;对每个缺失字段,给出会答错的真实问题类型、补救方式和可自动化验收规则。不要只评价字段命名。
验收分三层:解析、检索、回答必须分开测
最终答案正确可能只是碰巧;最终答案错误也不说明一定是模型问题。把黄金问题集(人工确认了问题、正确证据与答案的固定回归样本)拆成三层,故障才能定位。
| 层级 | 核心问题 | 最小测试 | 一票否决 |
|---|---|---|---|
| 解析层 | 原页结构还原对了吗 | 单元格值、行列、跨格、单位、脚注、页码对齐 | 金额/单位错误,关键字段漏失 |
| 检索层 | 必需证据找齐了吗 | 正确表进入候选;表头路径、行键和脚注同时出现 | 跨租户证据、正确表未召回 |
| 回答层 | 是否只根据证据计算与解释 | 数值计算、口径、引用、证据不足时拒答 | 无来源金额、引用指错页 |
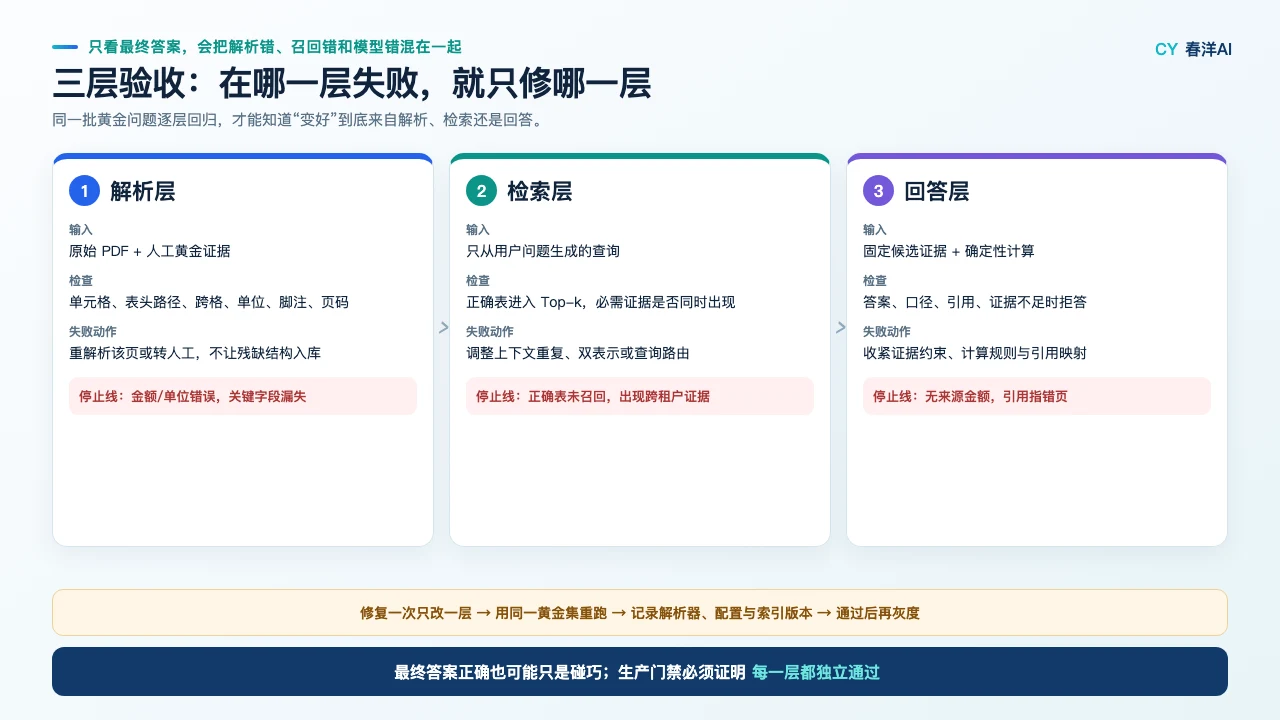
最终答案正确也可能只是碰巧;生产门禁要证明解析、检索和回答三层分别通过。
验收后的修复动作也要固定:解析层失败时重解析该页或转人工,不让残缺结构入库;检索层失败时调整表头重复、整表/行块双表示或查询路由;回答层失败时优先改证据约束、确定性计算和拒答规则。每次修复只改一层,用同一组黄金问题重跑,才能知道结果变好是谁的贡献。
T²-RAGBench把找对文本/表格上下文与后续数值推理放在同一任务链中,支持「检索和推理要分开观察」这个原则;它的论文结果不能直接变成你的生产指标。每个团队都需要从自己的账单、报表和手册中建立黄金集。
一次解析器升级至少记录:源文件指纹、解析器版本、结构警告、旧新中间层差异、两套索引结果和回归结论。这样出现错误时,才能回到具体页面和版本,而不是在「向量库可能不准」的猜测中打转。
🎯 实战提示词:请把下面的业务问题拆成解析层、检索层和回答层测试。每条测试写清输入 PDF、正确页码与区域、必需证据字段、预期答案、允许误差、失败归属和阻断级别。任何涉及权限、金额、单位或来源不可追溯的失败都标为阻断。
什么时候值得加视觉检索?
视觉检索(visual retrieval)直接利用页面图像中的版式、图表和空间线索召回证据。它适合「文字化本身会丢意义」的页面,不适合被当成所有 PDF 的默认补丁。ColPali 原始论文展示了直接对页面图像建立多向量表示的路线;OpenAI 的 PDF RAG 示例也同时演示文字抽取与页面图像分析。
值得升级的信号:
- 问题依赖图表趋势、颜色、连线、箭头或空间邻近;
- 同一页的文字抽取完整,但阅读顺序持续错误;
- 复杂表格结构置信度低,黄金问题反复失败;
- 用户需要直接查看原页证据,而不是只有转写文本。
暂时不值得升级的情况:
- 文档以干净段落为主,标题感知文本切块已经达标;
- 规则表格能稳定转成结构化数据;
- 业务问题主要是精确筛选、求和与分组;
- 页面图像索引、重排与多模态推理的成本或延迟尚无预算。
视觉路线不是消灭错误,只是把一部分 OCR 和布局误差换成页图索引、重排、推理成本和可解释性问题。正确做法是在视觉问题子集上做增量对照:若它没有稳定修复高价值失败,就不要全量开启。
从实验到生产:保护原件、中间层、黄金集和可回滚索引
春洋AI的判断是:解析 API 是可替换的工具。关键区别在于,原 PDF、开放格式中间层、黄金问题集和可重建索引才是需要优先保护的生产资产。
常见误区是把某家解析服务的输出当成唯一真源。云服务和自建工具都可以替换,只要核心数据不被封闭返回格式绑死。
- 原文件不可变保存:保存源文件指纹、版本与访问权限;重跑永远能定位同一个输入。
- 开放格式双写:结构化真值保存为自有 JSON/HTML/关系表;向量文本只是可再生投影。
- 按文档分类计账:分别记录快速文本、OCR、布局解析与视觉路径的页数、失败率、P95 延迟和实际成本。
- 最小权限隔离:PDF 内容只作为证据数据,不能改变系统规则或取得工具权限。OWASP 对间接提示注入的风险说明同样适用于文档知识库。
- 版本化索引:新旧解析结果进入不同索引。先在后台让同一批问题同时查询新旧索引,但仍把旧结果展示给用户;新路径通过验收后,再逐步把真实查询切过去。
- 单开关回滚:出现金额、单位、权限或引用错误时,能立即切回旧索引,不等待全库重建。
- 敏感日志最小化:记录标识符、版本、耗时与判定,不默认复制原始敏感内容到观测平台。
用三道发布门把责任落到人
| 阶段 | 知识库建设者交付 | AI 应用工程师验证 | 技术决策者作出的决定 |
|---|---|---|---|
| 单文档验证 | 代表性 PDF、结构化中间层、黄金问题 | 三层失败能定位到页、表和版本 | 是否值得进入小范围灰度 |
| 小范围灰度 | 文档分类与新旧索引 | 影子查询、成本、P95 延迟、阻断项 | 保持旧路径、扩大范围或回滚 |
| 正式上线 | 数据权限、保留策略、重建与回滚手册 | 监控、告警、审计链和一键切换 | 接受业务阈值并承担放行责任 |
阈值不能由解析器供应商代填:客服手册、合同和财务披露的错误代价不同。团队应先写清金额、单位、权限和来源不可追溯等阻断项,再为其余指标设业务可接受线。
如果数据不能离开内网,可以评估 Docling 这类本地结构化工具;但自建并不等于零成本,模型下载、算力、容量、升级和安全补丁都会转移到自己的运维账本。若使用云解析,也要把区域、保留策略、加密、私网连接和身份权限纳入验收,而不是只看「是否用于训练」。
这套方法也可以接到AI Agent 基础设施检查表和多 Agent 协作控制面:前者提供数据、工具、执行、记录与验证的生产闸门,后者提供任务标识、权限、审计和回归。
若知识库还会长期保留用户事实,还要同时参考Agent 记忆生命周期处理过期、冲突与删除传播。
常见问题
PDF 有文字层还需要 OCR 吗?
通常不需要默认 OCR。先直接提取文字并检查字符覆盖与阅读顺序;只有扫描页、不可搜索页或文字层质量不足时再升级。
Markdown 表格能保留合并单元格吗?
普通 Markdown 表格不能完整表达跨行跨列。复杂表格宜保存 HTML 或结构化 JSON,同时生成一份检索友好的文字投影。
表格应该整张入库还是按行切块?
两者都保留。整表用于全局比较,行块用于精确召回;行块必须重复表名、完整表头、单位和来源。
跨页表格如何拼接?
用重复表头、列数、坐标邻接、表名与续表标识生成候选拼接,再让黄金问题验收。不要假定解析器会自动完成。
数值计算为什么不全部交给语言模型?
求和、差值和分组是确定性任务,在结构化值上用 SQL 或代码更容易验证。模型更适合拆解查询和解释计算结果。
自建解析与云 API 怎么选?
敏感数据、可迁移与版本控制优先时偏向自建;快速验证和弹性优先时可以用云 API。两种选择都应落到自有开放格式中间层。
如何防止 PDF 里的恶意指令影响 Agent?
把 PDF 内容当作不可信数据,只允许它提供事实证据。系统规则、工具权限和高风险动作审批必须来自独立控制面。
什么是黄金问题集?
它是一组人工确认的问题、正确证据位置和答案,用于在解析器、切块、嵌入或索引变化后重复回归。
已有向量库需要一次性全量重做吗?
不需要。先给高风险文档建立新旧双轨索引,用黄金集对比;稳定后分批重建,并保留切回旧索引的开关。
结构化解析后还会错吗?
会。跨页、嵌套、旋转、低清扫描和特殊表单仍可能失败。结构化输出的价值是让错误能被检测、定位和修复,不是保证零错误。
上线前自检清单
- [ ] 原 PDF 有不可变版本和 SHA-256 指纹
- [ ] 关键表格保留表名、表头路径、行键、单位、脚注和页码/坐标
- [ ] 结构化真值与检索文本双表示,可从前者重建后者
- [ ] 普通文本、OCR、复杂表格与视觉页面有明确路由条件
- [ ] 黄金问题覆盖单值、比较、汇总、脚注、跨页和拒答
- [ ] 解析、检索、回答三层指标能独立观察
- [ ] 金额、单位、权限泄漏和来源不可追溯是一票否决
- [ ] PDF 内指令不能改变系统规则或直接取得工具权限
- [ ] 新旧索引可影子对比,并能用一个开关回滚
- [ ] 成本、P95 延迟和失败率按解析路径单独记录
完成标志不是「PDF 已进入向量库」,而是:给定一条回答,系统能指出它用了哪份文件、哪一页、哪个表头路径和哪组结构化值;任何解析升级后,这组证据都能被同一批问题重新验证。
相关教程
参考来源
- Google Document AI:Gemini layout parser
- Google Document AI:ProcessOptions
- Amazon Textract:Tables
- Azure Document Intelligence:Supported Markdown elements
- Unstructured:Partitioning strategies
- Docling 官方文档
- OpenAI Cookbook:How to parse PDF docs for RAG
- ColPali 原始论文
- TableRAG 原始论文
- T²-RAGBench 原始论文
- OWASP:Top 10 for LLM Applications